
蔚来AI Coding落地实战:车企从AI个人提效到组织智能的演进路径


汽车智能化竞争进入深水区后,软件研发效率决定了产品迭代速度,成为车企的核心竞争力。
一、背景:
汽车智能化竞争进入深水区后,软件研发效率决定了产品迭代速度,成为车企的核心竞争力。
蔚来数字座舱与软件开发部研发效能负责人李庆秋曾直言,团队面临的核心挑战在于:软硬件深度结合,一行代码可能牵涉到底层硬件适配和上层用户体验的微妙平衡;多技术栈耦合,座舱系统涉及Android、嵌入式Linux、RTOS等多个技术栈,每一个新功能都要跨多个系统协同;调用链路长,一个简单的用户操作背后可能经过数十个模块的串联调用;再加上多平台、多车型、多配置的业务复杂度,导致开发门槛极高。
2026年,蔚来与火山引擎TRAE合作,将AI编码工具引入智能座舱研发的核心生产环节,开启了一场从"个人效率"到"组织智能"的演进。目前,TRAE已覆盖蔚来智能系统、车载互联等核心研发场景,支持IDE/CLI/Work多种使用形态。
二、方式方法:三维评估,先算账再落地
蔚来不是盲目跟风上AI Coding的。在决定引入TRAE之前,他们从三个维度进行了系统评估,这是整个落地过程中最被低估但最关键的一步。
能力维度——TRAE是否具备在复杂座舱研发场景中真正"干活"的能力?不只是生成简单的代码片段,而是能理解多模块、多技术栈的工程上下文,生成可落地的生产级代码。蔚来的研发团队对此进行了大量实测,他们需要确认的不是"能不能写代码",而是"能不能在蔚来的研发体系里写对代码"。
成本维度——Token消耗、算力投入、团队学习和迁移成本,在可接受的范围内吗?TRAE的定价模型是否支持规模化部署?这是一个需要算细账的问题:如果AI Coding的Token成本加上团队学习成本,超过了传统开发方式,那"提效"就变成了"增负"。蔚来做了详细的投入产出测算,才决定规模化部署。
安全合规维度——代码数据是否留存于企业自有环境?模型会拿企业私有代码做训练吗?数据边界、权限边界、知识产权边界是否清晰?对于车企而言,核心代码资产的安全是底线问题。据了解,TRAE企业版以"代码不留存、不上传、不参与训练"为安全基线,通过了ISO 42001及等保三级认证,这成为蔚来最终选择的关键决策因素之一。
这个方法论的核心价值在于:AI Coding落地,不是先选工具再想怎么用,而是先想清楚自己要什么,再选合适的工具。
三、流程规范:三层AI代码审查体系
AI Coding落地最容易踩的坑是什么?代码质量失控。AI写代码速度快,但如果不建立有效的质量管控机制,代码库会迅速被"能跑但不可靠"的代码污染。
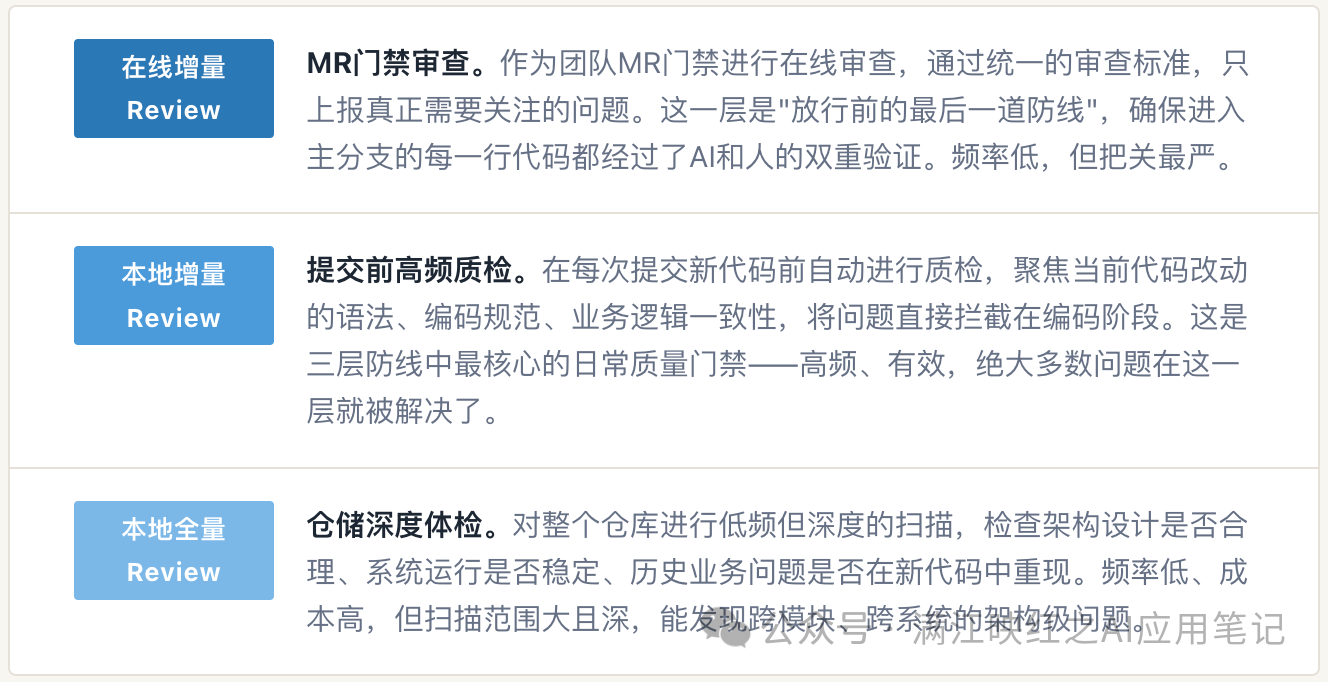
蔚来的解法不是"让AI只写代码,人来做审查",而是将AI本身嵌入审查流程,构建了一套完整的三层AI代码审查体系,让问题在最合适的阶段暴露和解决:
四、知识沉淀:从"经验在脑子里"到"知识在系统里"
蔚来面临的知识困境非常典型:新人入职,研发文档不全、代码量过大读取周期长、历史经验存在于老员工的脑子里。知识无法继承,每一次人员流动都意味着组织能力的流失。
蔚来的解法分两步走:
第一步,降低认知门槛。利用AI的上下文理解能力,将代码、文档、历史问题串联起来,自动生成项目入门Wiki,帮新人快速建立对项目的整体认知。这一步的价值在于,新人不再需要花数周时间"读代码、猜逻辑、到处问人"。
第二步,建立持续沉淀机制。开发过程中新产生的问题、架构变更、踩坑经验,都由AI实时总结并迭代进知识库。研发人员通过自然语言交互即可调取项目知识和前人经验,形成知识闭环。这个机制的关键在于:知识沉淀不是"额外的工作",而是"日常工作的副产品"。
这个闭环的真正价值在于:经验不再随人员流动而流失,每一次开发都在为下一次开发积累经验。组织能力的"复利效应"开始显现。
五、复杂问题定位:AI调取"比你更大的上下文"
在软件工程中,很多Bug不是新问题,而是前人踩过的坑。但问题在于,这些历史经验和解决方案分散在代码注释、Jira工单、聊天记录、个人笔记里,没有一个人能记住全部。
蔚来的做法是将代码上下文、Bug日志、评论及历史解决方案一并喂给AI,通过AI辅助分析并定位复杂问题。AI未必比资深专家更聪明,但能调取比专家更大的代码上下文和更全的历史经验。
据了解,团队内部多个长期悬而未决的"幽灵Bug",就是通过这种方式得到解决的。在AI的全局视角下,一些看似孤立的问题被关联到了数月前的一次架构变更,一些被反复重现的异常被追溯到底层依赖的一个边界条件。
六、组织变动:从"个人效率"走向"组织智能"需要体系化设计
这是蔚来AI Coding落地中最具结构性的变化——不是简单的"给每个人装一个AI编程助手",而是围绕研发全流程做体系化重构。蔚来构建了四层AI开发生态体系:
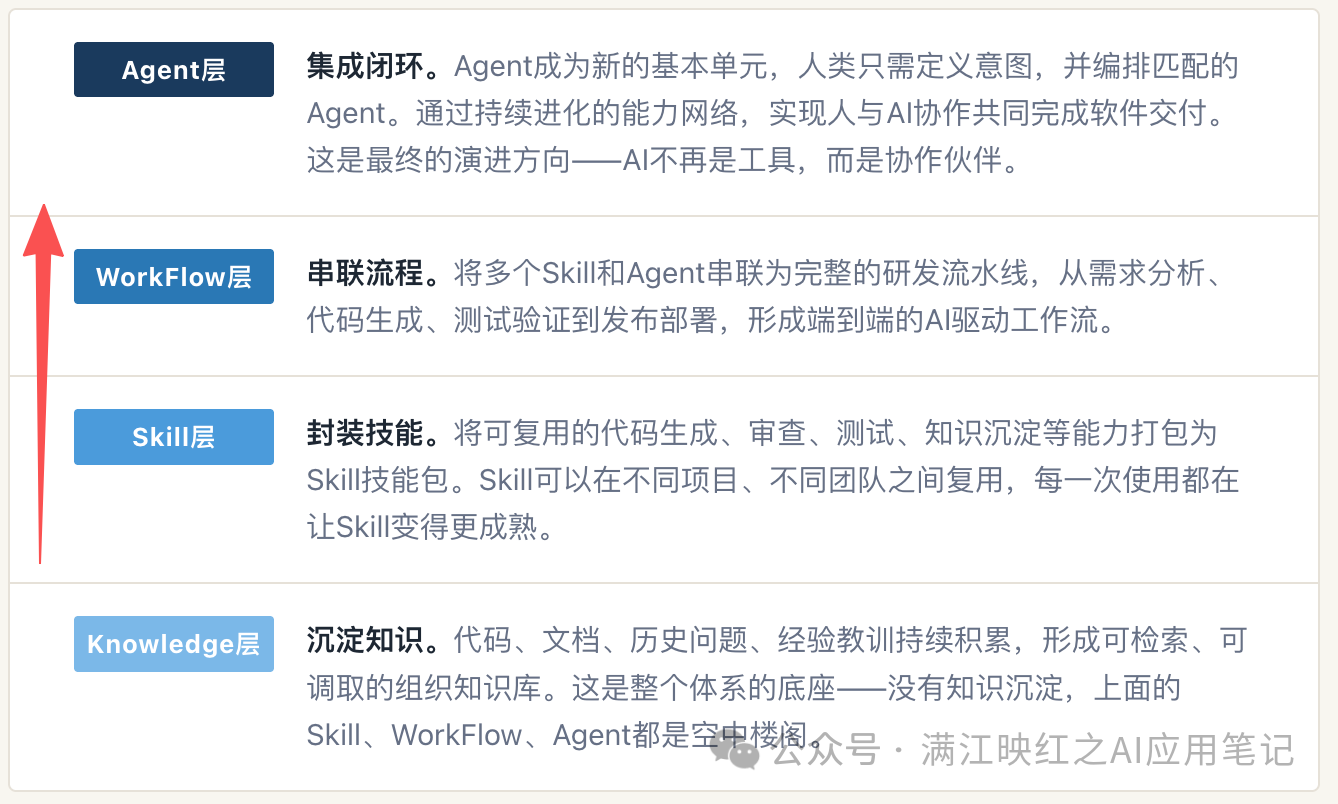
这个架构的演进路径是清晰的:
第一阶段,先让知识沉淀(Knowledge层),让AI成为"记住一切"的知识中介;
第二阶段,把可复用的能力封装为Skill(Skill层),让AI技能可以在不同场景间迁移;
第三阶段,将Skill串联为完整流程(WorkFlow层),让AI参与从需求到交付的端到端链路;
第四阶段,让Agent成为基本单元(Agent层),人类定义意图,AI自动执行。
这一演进的本质,是从个人效率走向组织智能。过去,经验属于个人——新人培养周期长、专家资源短缺、知识不断流失。如今,让AI参与到研发的每个流程,这些经验将属于组织,让组织能力能够持续积累、持续复用、持续放大。
七、困难瓶颈与克服方案
蔚来在AI Coding落地过程中,遇到了二个核心困难,它们的克服方式值得借鉴。
困难一:知识继承困境
研发文档不全、代码量过大读取周期长、历史经验存在于老员工脑子里——这是几乎所有研发团队的通病。
克服方案:不是让AI"帮人写文档",而是让AI"自动把过程变成知识"。当AI参与到代码生成、审查、问题定位的每一个环节,它自然就拥有了完整的上下文。将这个上下文转化为可检索的知识库,知识沉淀就成了"日常工作的副产品",而不是额外负担。
困难二:组织惯性
工程师习惯了现有的编码方式,对AI工具持观望甚至怀疑态度。特别是资深工程师,他们认为自己几十年的编码经验比AI更可靠。这是所有AI Coding落地中最难跨越的"人"的问题。
克服方案:蔚来做了两件事。第一,不强制,用效果说话。先让TRAE在部分团队中试用,让那些"先吃螃蟹"的工程师用实际成果证明价值。当张同学的Token用量从基础配额追加到1.5亿、曾同学1个月任务2周完成的数据摆在面前时,观望者自然就动心了。第二,把能力封装为Skill,让使用AI变成"复用团队智慧"而非"尝试新工具"。当AI生成的代码、审查、测试能力被打包成可复用的Skill,工程师使用AI不是"从零开始学一个工具",而是"站在团队已有的经验之上"。
八、真实案例:效率提升的数字与感受
案例一:某车载互联研发团队的张同学,已将TRAE作为日常主力IDE使用。他的Token用量从基础配额追加到1.5亿。他深度认可TRAE内置的SOLO模式和实时跟随功能,日常开发效率提升明显。同时他也是活跃的反馈者,多次提出具体问题帮助产品团队快速定位和修复体验问题。从一个"使用者"变成了"共建者"。
案例二:智能系统研发团队的曾同学,在开发某智能交互系统工具时,先用TRAE生成架构说明文档,再让TRAE读取模块设计规范、基于规范输出核心控制模块代码,最后用TRAE生成测试代码并沉淀成可复用的Skill。原本预估1个月的开发任务,实际只用了2周就完成。
九、结语:AI Coding的终点不是"写代码更快"
蔚来的实践表明,AI Coding在企业级落地的路径,不是"给每个人装一个AI编程助手",而是围绕研发全流程做体系化重构——从工具到流程,从个人到组织,从提效到沉淀。
在蔚来的案例中,我们看到了这样一条路径:三维评估选准工具,分层审查管控质量,知识沉淀构建壁垒,四层生态实现跨越。这是正在推进AI Coding的企业,值得思考的方法论框架。
- 暂时没有评论,来说点什么吧