
大模型涨价——公司毛利率掉了一半,API 收入涨了二十七倍


今年2 月,智谱把 Coding Plan 的价目表改了一遍,整体上调三成起。给的理由是用户规模和调用量涨得太快,
今年
2 月
,智谱把 Coding Plan 的价目表改了一遍,整体上调三成起。给的理由是用户规模和调用量涨得太快,要加大算力和模型优化投入。
这个行业习惯了「今年比去年便宜」,涨价是逆着来的。
半年后中报出来,需求没被压住。开放平台及 API 收入同比涨了二十七倍,到
8.25 亿
元。
拆开看,Coding Plan 的调用量比年初涨了二十多倍,API 平均售价提高约一倍。
牌价涨三成起,结算均价翻一倍。前者是标价,后者是实际付的钱。
01
涨的是价格,掉的是毛利
价涨了,API 这块业务确实开始赚钱:毛利率今年上半年刚由负转正,
24.6%
可公司整体毛利率从五成掉到两成六。
原因是结构。毛利高的本地化部署收入占比下降,毛利低的 API 收入占比升到八成以上,加权之后,整体毛利率就往下走。
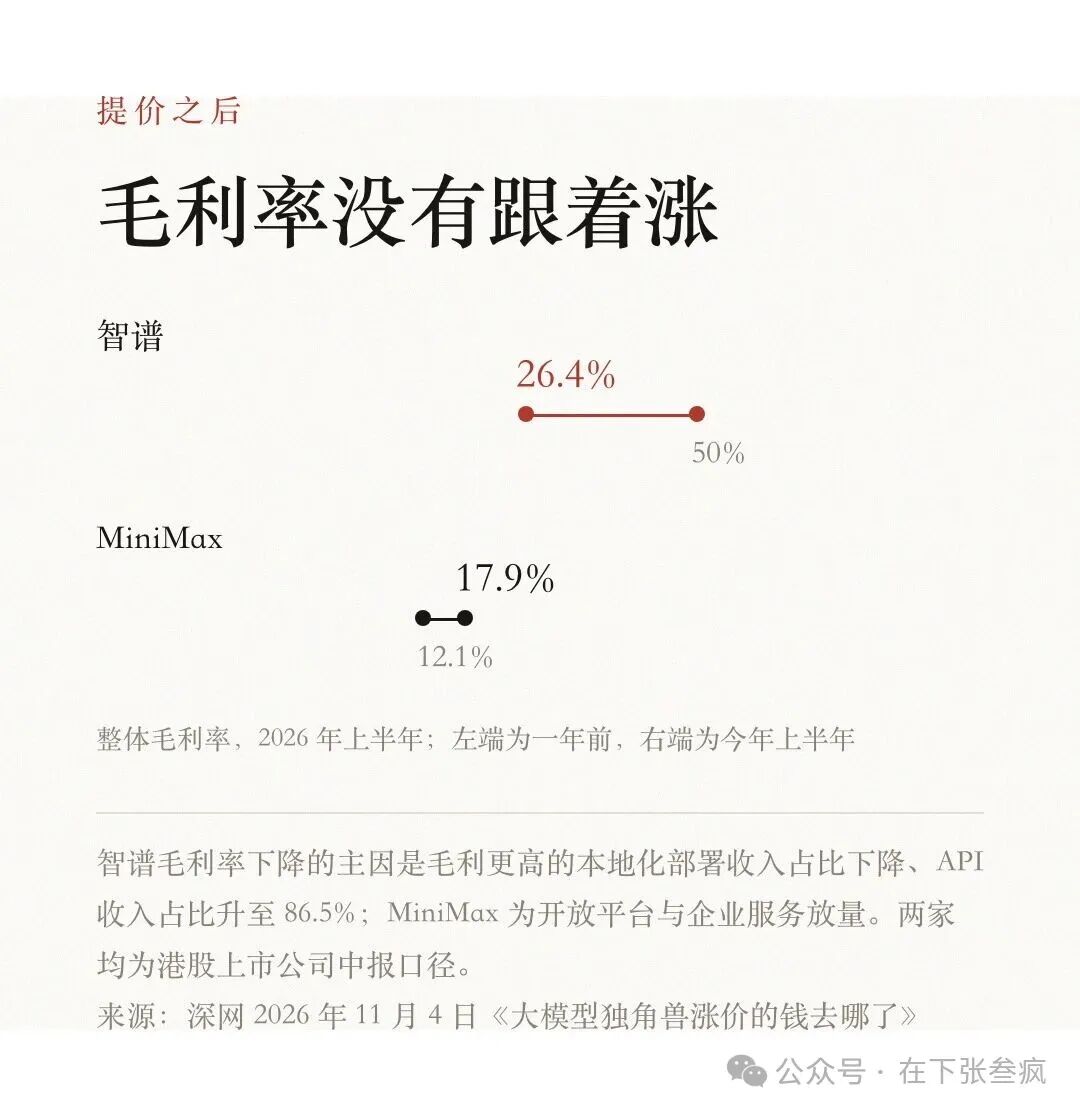
图1
两家港股上市大模型公司的整体毛利率,左端为一年前,右端为今年上半年。来源:深网 2026 年 11 月 4 日《大模型独角兽涨价的钱去哪了》;智谱下降主因是本地化部署占比下降、API 占比升至 86.5%
MiniMax 走的是另一条路:毛利率升了几个点,但上半年毛利只有约
2080 万
美元。它的办法是降成本,没涨价。
闫俊杰在中期业绩电话会上说,过去两个多月,文本模型的单位算力吞吐提高了
3 倍
。到
7 月
,平台 Token 消耗量已经是年初的
20 倍
吞吐上去,单位成本下来,毛利率就是这么升起来的。
同样是抢编程场景,动作都不一样:月之暗面
4 月
涨了五成多,
10 月
又降了三成;DeepSeek 把不同模型的价格提到原来的两倍多到四倍多。
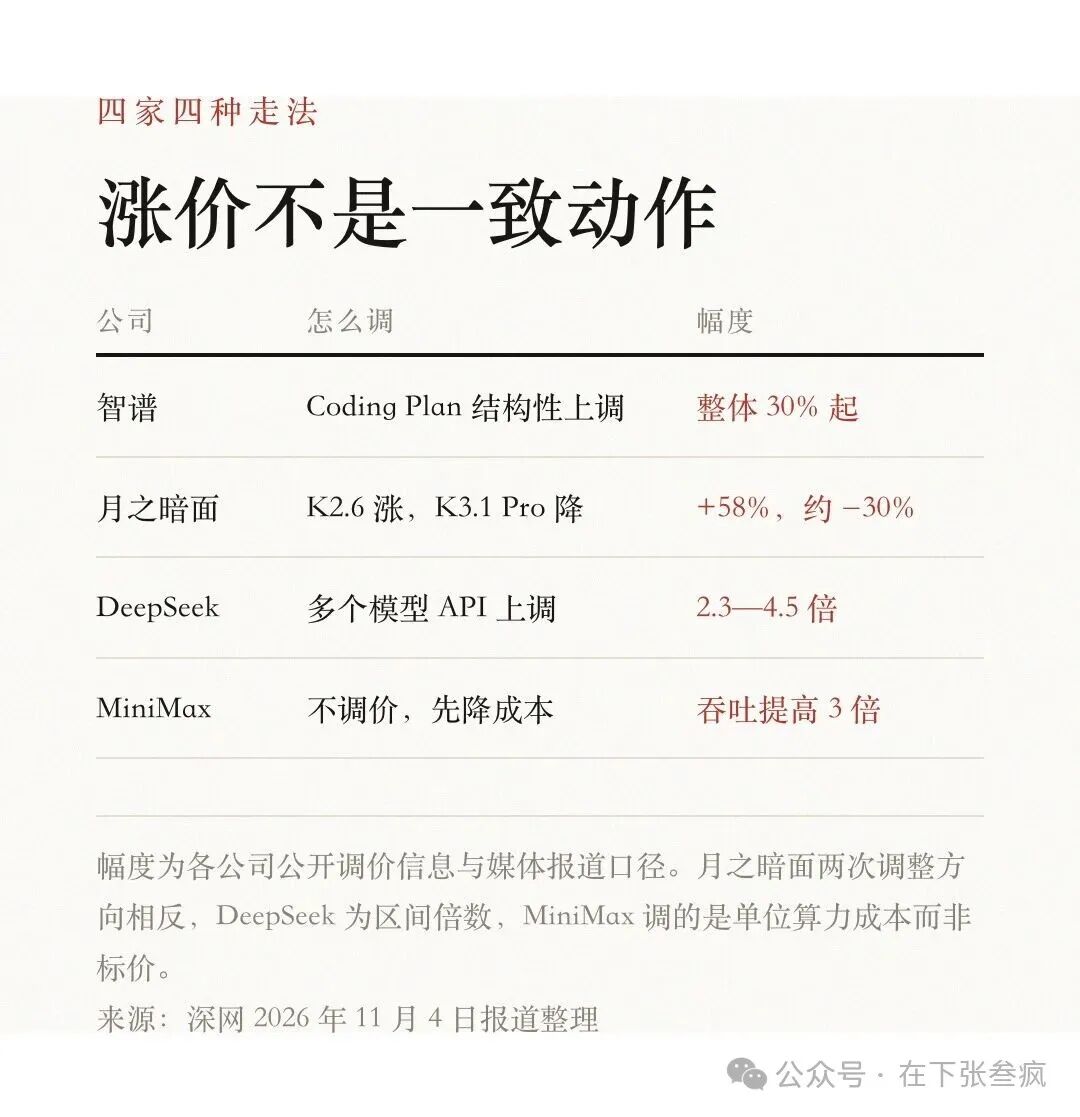
图2
四家四种走法。来源:深网 2026 年 11 月 4 日报道整理;月之暗面两次调整方向相反,DeepSeek 为区间倍数,MiniMax 调的是单位算力成本而非标价
敢不敢涨,看的是场景。朱啸虎说,编程是今年少数「需求刚性、产出容易衡量」的场景。代码跑不跑得通、省了多少工时,开发者一试就知道。
02
钱没有变成利润
毛利往下走的同时,两家都还亏着。吃掉净利的是研发:今年上半年,两家的研发开支都是同期收入的两倍多。MiniMax 花了近
3 亿
美元,主要用在训练相关的云服务上。
一个亏超
20 亿
元,一个亏近
3 亿
美元。
填这个缺口的是融资。
7 月
,智谱配售新股募了约
314 亿
港元,MiniMax 通过配股和可转债净筹约
159 亿
港元,钱主要投向算力。买卡和付电费,都算在里面。
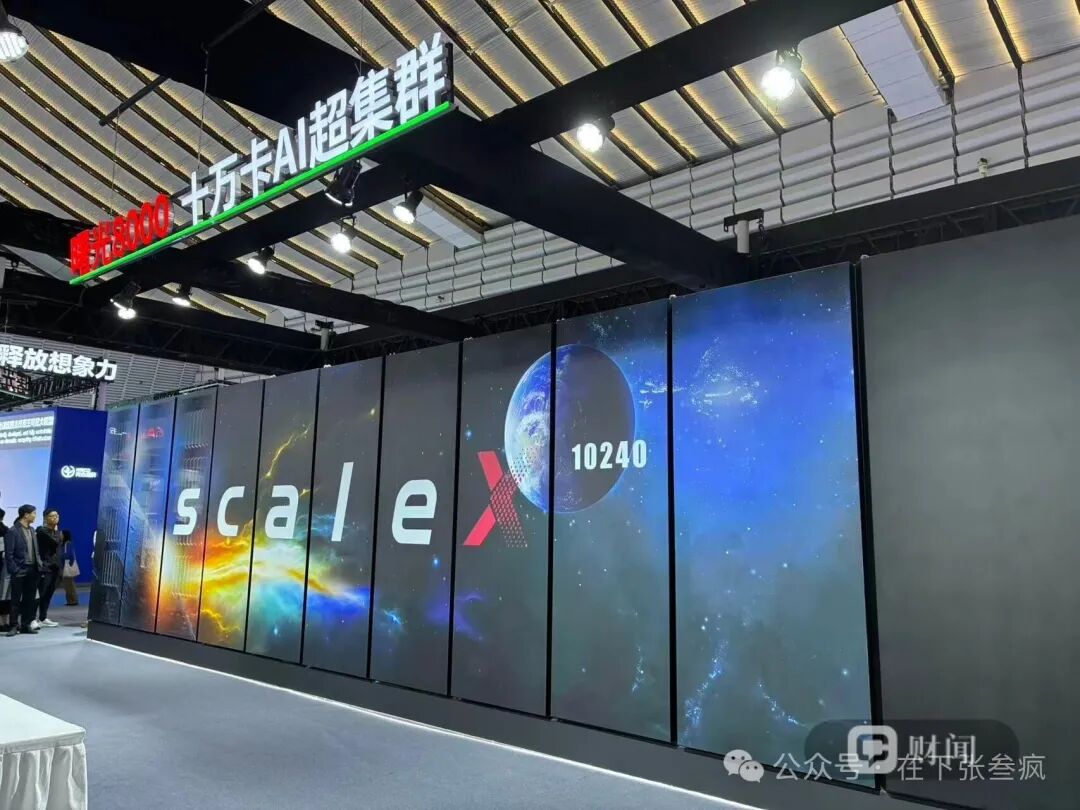
图3
2026 年 11 月 4 日乌镇「互联网之光」博览会中科曙光展台,招牌写着「曙光8000 十万卡 AI 超集群」。来源:财闻 2026 年 11 月 4 日报道所附现场照片;画面为展会现场,与文中智谱、MiniMax 的采购无直接对应关系
03
夹在中间的人
头部在抢编程,中小公司只能往缝里钻。你调 API 的时候,中间可能还隔着一层。
澜舟科技联席 CEO 李京梅说:「他们跟客户签,我们跟他们签。」有些大厂的订单进了云厂商的采购体系,再转给澜舟做开发。
这家做过「孟子」预训练模型的公司,
2024 年
停了基础模型训练,此后基本退出通用平台,业务集中到金融等专业领域的智能体上。
她对国内 B 端市场的判断是:「能超过五成的,用标品去交付,已经是在中国的 B 端市场不错的。」
剩下那五成是什么?是一家银行总部的法律合规问答项目。
澜舟原本拿标准产品进场,后来发现专业术语、法条版本、口语化提问都不够用,只能额外开发;系统上线后还要试运行,附赠一年免费运维。
单价也在往下走。零壹智库的统计是,今年
9 月
披露金额的金融机构智能体中标项目,平均每单约
211 万
元。
这些项目预算提前一年定好,要公开招标,常常低价中标,算力支出还从同一笔钱里出。
热钱同时在往头部集中。IT 桔子的数据是,今年三季度只有 43 笔超
10 亿
元的融资,卷走了全市场近一半的钱,企业服务领域平均每笔融资已经缩水到约
3300 万
元。
你的报价单如果来自这一层,谈价的余地比头部小。
04
明年别按降价做预算
如果你是开发者或者企业的技术负责人,过去几年「等下一代模型更便宜」的经验,在国产模型上开始失效。能做的有三件事。
多留一家备选,别把整条业务线押在一个模型上。
把长周期调用谈成锁价,别用按量浮动价格做年度预算。
算一遍自己的毛利,业务本身只有十几个点的话,模型成本涨一倍,这门生意可能就不成立了。
- 暂时没有评论,来说点什么吧