
当"会想象"的AI撞上物理世界:华为云CloudRobo具身世界模型的答卷


【赛迪网讯】2026年,"具身智能"几乎是资本市场上最性感的词之一。但热闹背后有个尴尬事实:真正走进物理场
【赛迪网讯】2026年,"具身智能"几乎是资本市场上最性感的词之一。但热闹背后有个尴尬事实:真正走进物理场景、能稳定干活的机器人,依然屈指可数。行业逐渐形成一个共识——瓶颈不在机械本体,而在"大脑"。于是"世界模型"被推到聚光灯下:让AI不仅能看见当下,还能预测未来。
问题是,这条路有多难,又有多贵?
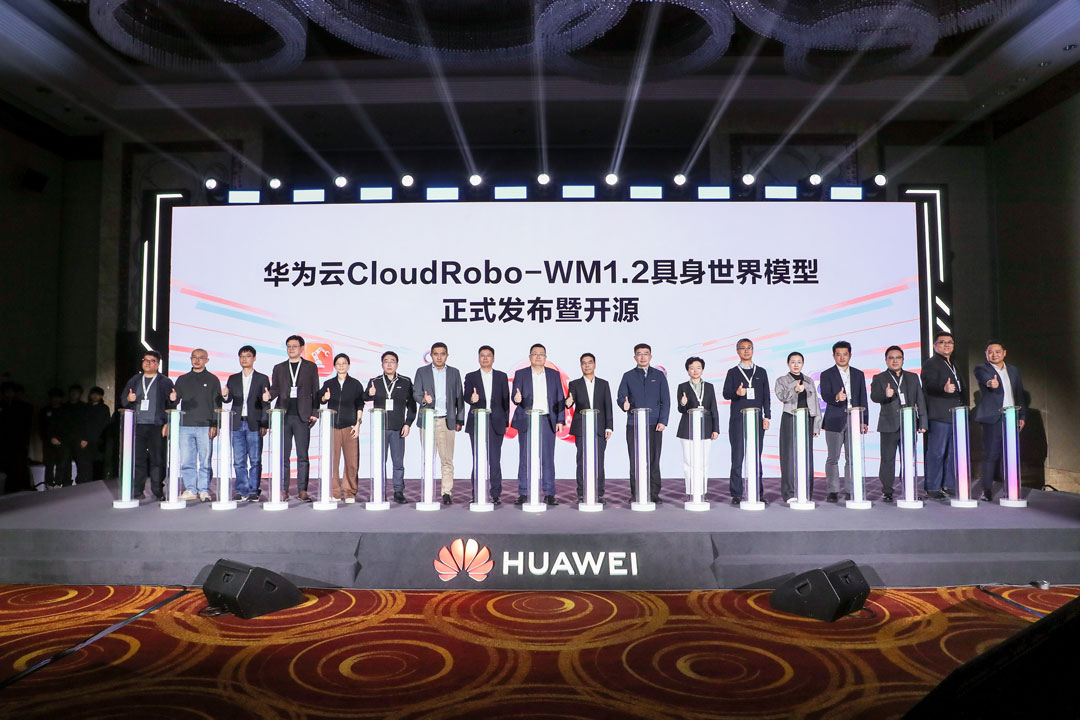
11月16日,华为云在线上发布昇腾原生具身世界模型CloudRobo-WM1.2。它回答的其实是一个更尖锐的追问:用国产算力,到底能不能训练出顶级的具身世界模型?
先诚实承认:五大真问题摆上台面
发布会最值得称道的一点,是没有回避困难,而是把行业的硬伤用数据摊开。
传统视觉表征太依赖"当前画面里看得见的东西":关键目标检测一遮挡,识别得分(F1)就从68%跌到28%;模型只在固定视角训练,遇到高位视角会从62.72%崩到7.62%,近乎瞎猜;有模型能精准读出"位置",却对"速度"几乎无感——物理推理准确率只有19%,而在IntPhys 2基准上,没有一个模型超过60%,人类多数能达96.44%。
第二道坎更隐蔽:世界认知和动作生成"不是接上就行"。紧耦合能保留物理直觉,却常常掉出实时控制的门槛;松耦合能把延迟压到几十毫秒,又要靠额外对齐去弥补成功率。
再叠上三座大山:真机数据500–2000元/小时的贵,跨本体"换硬件就崩盘"(成功率从98%跌到18%),生成未来画面动辄吃掉近20 GiB显存。
华为云对此的判断,是整场发布会最该被记住的一句话:世界模型的"想象节奏"和机器人的"反应节奏"之间,存在一道需要架构层面去弥合的结构性时延鸿沟。
CloudRobo-WM1.2:不堆参数,在架构上做文章
五大核心技术,几乎是一一对应上面五个挑战,思路很清晰——问题出在架构,解法也要在架构。
PPA(感知-预测-行动)多模态世界表征,让机器人从"能看静态照片"进化到"能看懂一场正在发生的4D动作电影"。它看到一个杯子,不仅知道它是什么、在哪,还能预判推一下会不会倒。
世界模型原生DualAct架构,官方解释是"同一个懂世界的大脑,两种动作生成路径"。类比很形象:人有不经过大脑皮层的膝跳反射,快而直接;也有后天习得的"谈虎色变",准而智能。DualAct要的就是既快又准,还支持开发者灵活定义动作专家尺寸。
四种可组合的弹性推理模式——被形容为"像点菜一样,丰俭由人"。客户可按算力和时延要求,在Joint/Action-only、World Action/Expert Action之间自由搭配。
结果也够硬:CloudRobo-WM1.2在RoboTwin 2.0、LiberoPro 2.0两项评测中均位列第一。 这是"国产算力能训出顶尖世界模型"最有力的注脚。
真正的野心:做具身智能的"硅基黑土地"
如果只把它看成一次模型发布,就低估了这场发布会。
华为云透露,昇腾云在具身智能市场格局中国第一,已有80%的中国具身智能企业选择昇腾云,重点高校基本实现全覆盖。底层的工程支撑也很实在:RLinf v0.4对昇腾NPU的支持大幅增强,实现最高2.78倍吞吐提升。
战略层面是"技术深耕+开放赋能+生态共建"三位一体,全面开源、深度开放。会上,华为云与环卫龙头福龙马集团联合研制的智能清扫机器人已启动预售,12月将在上海召开发布会——这是"从模型走向真实作业"的第一个落地信号。
从卖算力到做生态入口,这是一次升维竞争。华为云给自己的定位是"做最懂具身、最先进、最开放的硅基黑土地",这五个字既是宣言,也是对整个行业的邀约。
赛迪观察
世界模型路线之争远未结束,耦合之难、时延鸿沟仍是没有被彻底解开的结。CloudRobo-WM1.2的可贵,在于它把鸿沟摆到架构层面去正面应对,而不是绕过去。
但真正的答案,不在评测榜单的第一名里,而在千行百业的车间、街道、仓库里。能用国产算力训出领先模型,是入场券;能让机器人稳定干成活,才是终局。(文/徐培炎)
- 暂时没有评论,来说点什么吧